Kontextfenster.
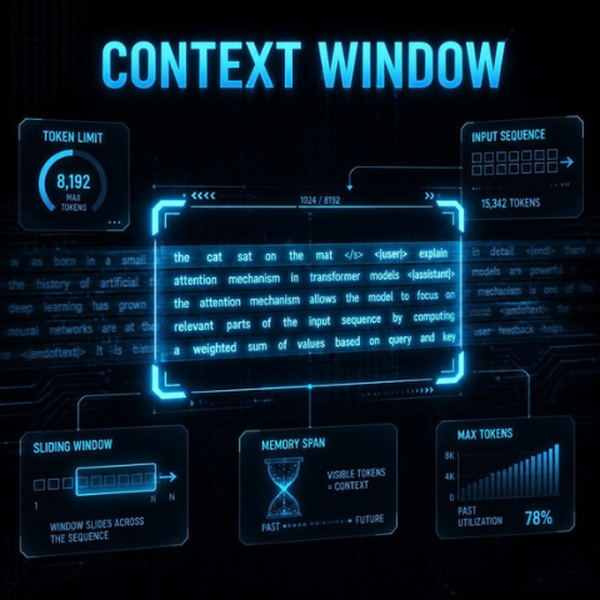
Ein Kontextfenster ist die maximale Menge an tokenisierten Daten, die ein Large Language Modell in einem einzelnen Generierungsvorgang verarbeiten und berücksichtigen kann. Gemessen wird diese Grenze in Tokens statt in gewöhnlichen Wörtern, sie bestimmt, wie viel Eingabetext das Modell aktiv analysieren kann, um seine Antwort zu erzeugen. Alle Informationen jenseits dieser Grenze sind dem Modell während dieses Verarbeitungsschritts nicht zugänglich.
In der generativen künstlichen Intelligenz fungiert das Kontextfenster als aktives Arbeitsgedächtnis eines Large Language Modells. Da diese Modelle Informationen in Einheiten namens Tokens verarbeiten, die Textabschnitte statt ganzer Wörter repräsentieren, wird die Kapazität dieses Fensters über die Anzahl der Tokens definiert. Bei der Erzeugung einer Antwort kann das System nur auf die Daten zugreifen, die aktuell innerhalb dieses Fensters liegen. Text, der diese Grenze überschreitet, etwa ein außergewöhnlich langes Dokument oder ein langer Gesprächsverlauf, liegt außerhalb des unmittelbaren Blickfelds des Modells. Um Informationen jenseits dieser Schwelle zu verwalten, müssen Systeme auf externe Techniken wie Zusammenfassung oder Retrieval zurückgreifen. Ein größeres Kontextfenster ist entsprechend von großem Vorteil, da es dem Modell erlaubt, umfangreiche Aufgaben, etwa die Analyse ganzer Codebasen oder langer juristischer Dokumente, zu bewältigen, ohne wichtige Details durch Datenkompression zu verlieren.